
シリーズ第1回では、アプリを作り始める前に開発基盤を整えた話を書きました。第2回では、その基盤の上で最初に立ち上がった「番頭シリーズ」——ダッシュボードを作り込むほど見なくなり、そこから朝のブリーフィングへと情報の届け方を変えるまでをご紹介しました。シリーズの全体像は Proof of Concept(概念実証)ページ にまとめています。
ただ、実際に番頭が動き始めた頃、AIとの役割分担は、まだ固まっていませんでした。第1回の終盤で書いた .env の上書き事故は、その象徴です。良かれと思って進めてくれたことが、別の問題を生む。口で「上書きしないで」と伝えても、状況によっては同じことが起きる。
この記事では、その後、AIとの分業がどういう型に落ち着いたのかを紹介します。先に結論を言うと、AIに丸投げしてもうまくいかない原因は、指示の出し方ではなく、ひとつのAIに全部を相談していたことでした。
私は以前から、AIは「拡張脳」だと書いてきました。ただ、それはAI全体を指した言葉ではありません。自分の思考のパートナーになるAIのことです。考えを受け止めて、整理して専門用語に翻訳してくれる相談相手——これが拡張脳です。
そして、それとは別に、ツールの側につくAIがあります。翻訳された指示を受け取って、実際に形にする担い手です。この両方が揃って初めて、望んでいることが実現しやすくなる。
今回の場合、思考に寄り添う拡張脳がClaude Desktop、ツール側がClaude Codeでした。そして、ツール側は領域によって入れ替わります。ウェブデザインならClaude Design、スライド編集ならClaude for PowerPoint。拡張脳は変わらず、手を動かす相手が変わるだけです。この記事では、前者を設計を担うアーキテクト、後者を実装を担うプログラマーと呼んでいきます。
最初は、ひとつのAIに丸投げしていた
MCPで自宅サーバーと繋がった時点で、私はClaude Desktopから直接、開発をしていました。相談も、設計も、実装も、全部を同じ相手に投げていた、ということです。会話の流れの中で「こういうものが作りたい」と話すと、そのまま作ってくれる。当時はそれが自然に思えました。
たとえば、ダッシュボードを作りたいと言う。するとClaude Desktopは、こちらのイメージを聞いたうえで、指示書もなしに、そのまま作り始めてしまう。
このやり方でも、何かがうまくいかないときは、いろいろとチャレンジしてくれます。ただ、何をしているのかが、こちら側には表示されない。ただ、不安に待たされるのです。
そして待ったあとで結果を聞いてみると——「それなら、別のアプローチでやればよかったのに」と思うことが、何度かありました。方向が違うと分かるのが、いつも終わったあとなのです。
ここは、はっきりさせておきたいところです。Claude DesktopとClaude Codeを分けた理由は、性能が足りなかったからではありません。何をしているのか見えなかったからです。時間はかかる、中は見えない、終わってから方向違いに気づく。この不透明さが、分けるきっかけでした。
そして、これはAIに限った話ではないと思っています。人に頼むときも、同じことが起きます。あれも考えて、これも考慮して、と期待する範囲を広げていくと、何を優先すればいいのかが決まらなくなって、かえって動けなくなる。丸投げがうまくいかないのは、相手がAIだからではなく、役割が決まっていないからです。
これは、AIを職場に入れた多くの担当者が口にする「任せてはみたけれど、中で何が起きているのか分からなくて怖い」という感覚と、同じものだと思います。
指示書から始めると、迷子にならない
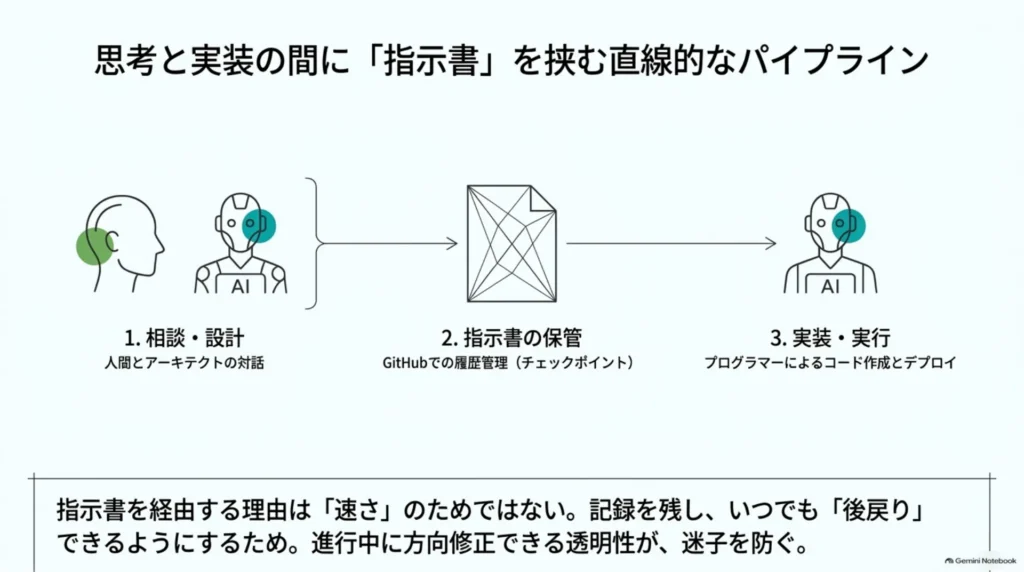
そこで、開発の実行はClaude Codeに任せ、必ず指示書から始めさせる形に変えました。
この形にすると、何が変わったか。
- ゴールが明確になっているので、途中でアプローチを変えても、迷子にならない
- 作業のステータスが出ているので、おかしいと思ったら、作業の途中でもコメントを入れて、すぐに止められる
終わってから「別のアプローチでよかったのに」と思う代わりに、進んでいる最中に方向を直せるようになった、ということです。
指示書をファイルの形にしているのにも、理由があります。ファイルにして進めれば、あとで振り返りができるし、何かあったら戻ることもできる。単純なことです。速さを競っているわけではなく、記録と、後戻りのためです。
この指示書の置き場所も、途中で一度変えています。最初はクラウドストレージに置いていましたが、履歴管理がしやすいという判断で、GitHubに置く形に切り替えました。第1回でサーバーの構成を組み替えたときと、同じことが分業の型のほうでも起きた、という感じです。使ってみて、不便なら変える。
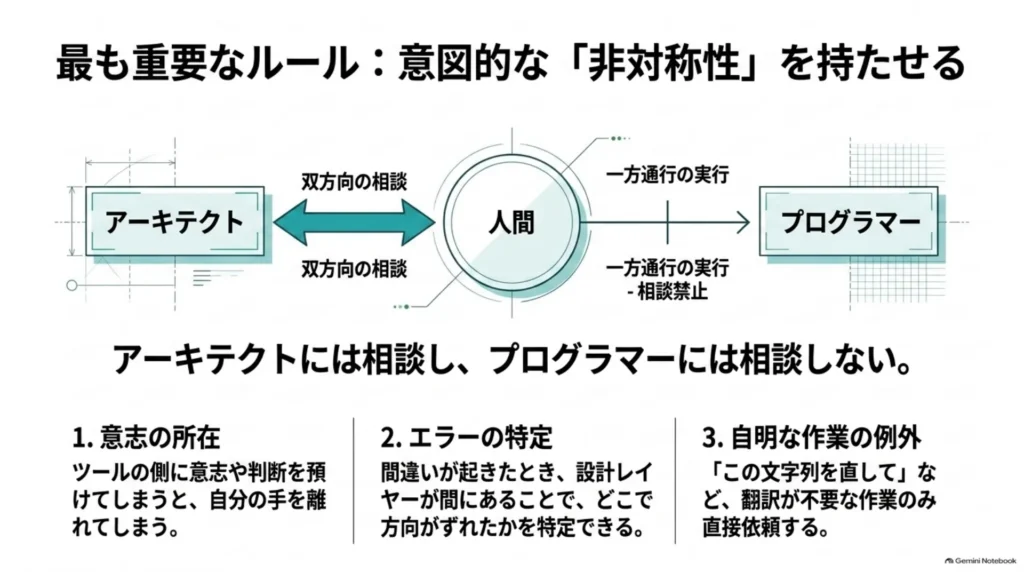
なお、すべてが指示書を経由するわけではありません。「この文字列を直して」といった、翻訳のいらない自明な作業は、Claude Codeに直接お願いすることもあります。境目は「翻訳が要るかどうか」です。やりたいことを実行できる形に翻訳する必要があるものは、必ず相談から始める。その必要がないものは、そのまま渡す。
アーキテクトには相談し、プログラマーには相談しない
整理すると、私とAIの役割分担は、こうなっています。
- 私——何をしたいのか、なぜそれが必要なのか
- 設計を担うアーキテクト(Claude Desktop)——自分の側につく拡張脳。技術を整理し、方針を決め、構成をまとめ、指示書に落とすところまで
- 実装を担うプログラマー(Claude Code)——ツールの側につくAI。指示書を受け取って、コードを書き、コミットし、デプロイまで
ここに、意図的な非対称性を置いています。同じClaudeでも、アーキテクトには相談し、プログラマーには相談しません。方針や判断が絡む瞬間は、必ずアーキテクトに戻る。プログラマーに意志は預けない。
理由は単純で、立っている側が違うからです。拡張脳は自分の側にいるので、まとまっていない考えのまま預けて、一緒に整えていける。プログラマーは自分の外、ツールの側にいます。そこに意志まで渡してしまうと、何をどう決めたのかが、自分の手を離れてしまう。
任せっぱなしにしないのは、不精だからではありません。間違いがどこで起きたかを、見つけられる構造を残しておきたいからです。設計というレイヤーが間に入っていれば、方向がずれたときに、どこでずれたのかが見えて、直せます。
そして、この形にしたあとも、アーキテクト役のClaude Desktopが自分でコードを書こうとすることは、今でもたまにあります。そこはいさめて、できるだけClaude Codeに渡すようにしています。ルールを決めれば、AIが勝手に守ってくれるわけではない。人間の側が、いさめ続ける必要はあります。
結局のところ、役割をちゃんと定義できるかが、上手に回すには大事だ、というところに行き着きました。
どこで「十分」とするかは、人が決める
この非対称性が効いた場面を、ひとつ書いておきます。食料品管理の「クラ番(蔵番)」を作ったときの話です。
もともと先にあったのは、レシピをAIに相談できる「アジ番(味番)」のアイデアでした。ただ、それを成り立たせるには、冷蔵庫の中身が把握できている必要があります。そこで、保存食から生鮮食品まで無駄なく使えるように、食料品を管理する仕組みとしてクラ番を考えました。
問題は入力です。毎日変わっていくものを手で登録し続けるのは、現実的ではない。それなら、レシートをキャプチャして拾えばいいのではと考えました。
ところが、実際にやってみると、サーバーに入れたOCRのコンポーネントでは認識精度が高くなく、使い物になりませんでした。そこでGoogleのAPIを使ったOCRに変え、無償で使える範囲でどこまでできるかを試したところ、インストール型のものより精度が高く、良い結果が出ました。
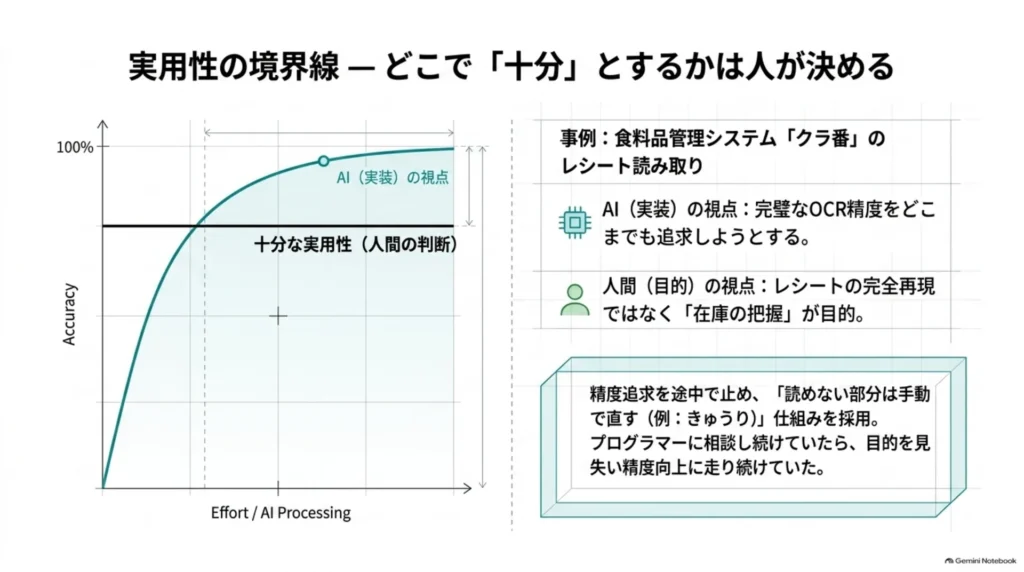
もっと精度を上げることも、技術的には可能でした。ただ、試すうちに分かってきたのは、レシート側もスーパーによって表記が違うということです。そうなると、何の野菜なのか読み取れなかったり、いらない小計の値が混ざったりする。これは精度の問題ではなく、元のデータのばらつきの問題です。
そこで、精度をさらに追いかけるのをやめて、手で直せる仕組みを足しました。読み取れなかったところを「きゅうり」と直してあげれば、使えるデジタル保管庫として成立する。100%全部読み込めてはいないけれど、簡単に読み込めたのだから、それでいいじゃないか、と考えたわけです。
ここが、役割を分けている意味の出るところだと思っています。精度をどこまで上げられるかは、実装の話です。しかし、どこで「十分」とするかは、私の側にしかない。目的は在庫を把握することであって、レシートを完全に再現することではない。プログラマーに相談していたら、たぶん精度を上げる方向に走り続けていました。
前提条件を、どこに置くか
役割を分けると、次に効いてくるのが「前提条件をどこに置くか」です。
AIを使い始めて一番最初に気になったのは、次のチャットになると、これまでの内容が引き継がれないことでした。最初は、次のチャットのために引継ぎ文を作ってもらう、というごく普通の対処をしていました。そこから、プロジェクト、メモリ、スキル、設定ファイルと、いろいろな方法があると分かってきて、どの前提条件をどこに配置するかを、アーキテクトと相談しながら決めていきました。
今の形は、こうなっています。
- プロジェクト——前提条件が異なる領域ごとの器(開発 / 会社運営 / 資産管理 / SEO・コンテンツ)
- メモリ・共有ファイル——そのプロジェクトの中の環境
- スキル——どのプロジェクトでも使える横断型の手順
- ルールファイル——固有の環境とお作法を、単一の正としてまとめたもの
この整理が効くのは、相談の入口が安定するからです。何かをやりたいとき、私はまず開発のプロジェクトでアーキテクトに相談します。そこには、サーバーやクラウドなど、使えるリソースがすべてまとまって記載されています。だから、どうすればいいかだけでなく、どういうコードを書けばいいかまで、把握したうえで話ができる。
ただし、ここではコードを書かせません。全体のプランだけを、私と話しながら作っていきます。それが指示書となってGitHubに保管され、プログラマーはその指示書を見て作業を始める。
このバランスにしておくと、何かが起こっても、相談先と担当される内容がはっきりしているので、ことが進めやすい。そう感じています。
これでいいのか、もっと良いやり方があるのか
ご紹介したアプローチは、私の環境での試行錯誤の結果です。ただ、進めながら、ずっと引っかかっていました。このやり方は、自分だけがやっているのか。それとも、もっと良い方法があるのか…
そう思って調べているうちに、ひとつの調査に行き当たりました。
Anthropicが2026年6月に公開した、2025年10月から2026年4月にかけての約40万セッション(約23万5千人分)を分析したものです。そこで観測されていたのは、人が計画の判断のおよそ7割を担い、AIが実行の判断のおよそ8割を担うという分かれ方でした。私が試行錯誤の末に落ち着いた形は、多くの人が同じように辿り着いている形だったのです。
さらにこの調査には、私にとって腹落ちする結果がありました。成否を分けるのは、コーディングの経験ではなく、自分が何を実現しようとしているのかを、どれだけ理解しているかという点です。検証可能な成功率で見ると、ソフトウェアエンジニア以外の職種も、そこから大きく離れない位置にいた。
振り返ると、確かにそうでした。技術的に判断が分かれるところ——例えば、サーバーの構成をどうするか、どのコンポーネントを使うか——は、アーキテクトに解説してもらえば自分で選べます。しかし自分でしか決められないものは、何を作りたいのか、どうあってほしいのか。これを言葉にできるのは、自分しかいない。私が上手く組み上げられたのは、たぶん、この実現したいことを表現し続けてきたからです。
そして、この考え方は組織内のビジネスのシーンでも同様に扱えます。例えば、複数人で進めるなら、それぞれが同じようにアーキテクトとプログラマーのペアを持てばいい。前提条件をまとめたプロジェクトは共有できますし、指示書はGitHubに置いてあるので、全員が同じものを見られます。人でもAIでも、ちゃんと情報共有しながら前に進めることが可能です。
もし、これから組織でAIと組もうとしている方に最初に何を伝えるかと聞かれたら、私はコンテキスト(文脈)と、役割と、環境だと答えます。AIチャットが前の会話を覚えていないという仕組みを理解すること。チャットの前提条件をどう立てるか決めること。役割別に動きを設定すること。そうした環境を整えていくこと。これが、迷子にならない方法じゃないかなと考えています。
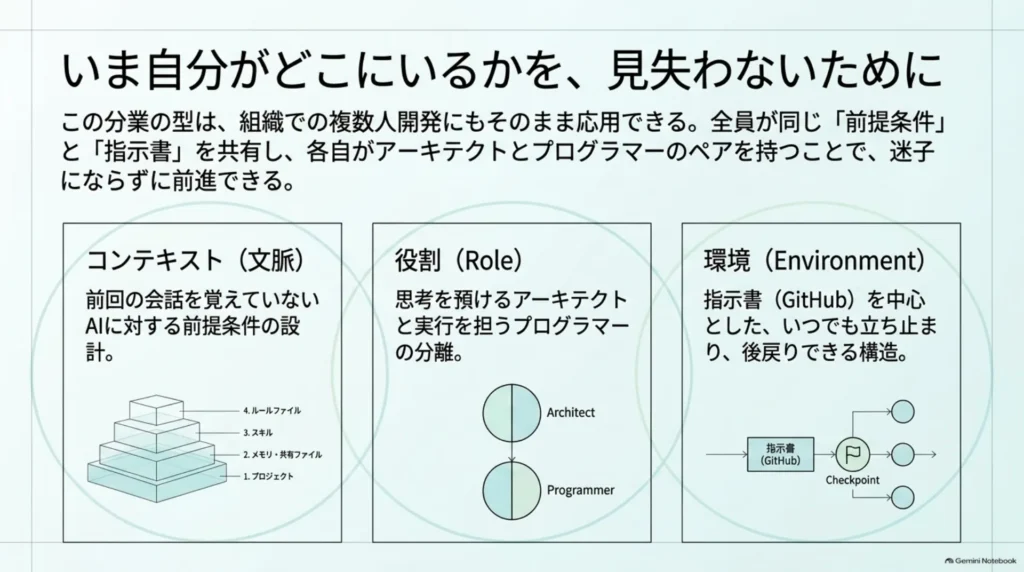
そう考えると、ここまでご紹介したことは、指示書から始めるのも、アーキテクトとプログラマーを分けるのも、前提条件を置き場所ごとに整理するのも、速く進むためではなく、いま自分がどの方向に何をやっているかを見失わないためでした。
次回は、この分業の型で実際に何を作ったのか——業務電話のAI受付「ハンナ」の実装記録を紹介します。
▼ 参考
本文で触れた調査は、Anthropic「Agentic coding and persistent returns to expertise」(2026年6月16日公開)です。2025年10月〜2026年4月の約40万セッション、約23万5千人分を、プライバシーを保護した形で分析したもの。計画の判断と実行の判断の分かれ方、解こうとしている問題の理解度と成功率の関係などが報告されています。